शून्य बिंदु: बैडमिंटन की वह खबर जो स्कोरबोर्ड पर थी और पाइपलाइन में मर गई
**मुख्य उत्तर:** बैडमिंटन डेटा पाइपलाइन में 'शून्य पेलोड' का अर्थ है कि स्टेज-1 एक्सट्रैक्शन ने शून्य सूचना बिंदु लौटाए, इसलिए कोई खिलाड़ी, मैच या टूर्नामेंट सत्यापित नहीं हो सकता। सही व्यवहार EXTRACTION_FAILED लौटाना है, N/A के साथ आगे बढ़ना नहीं। **मुख्य तथ्य:** - स्टेज-1 के चार मुख्य फील्ड — शीर्षक, स्रोत, सूचना बिंदु, मुख्य दृष्टिकोण — सभी खाली या N/A लौटे, सैंपल आकार शून्य रहा। - स्वीकृति मानक: कम से कम 5 एटॉमिक सूचना बिंदु और नामित एंटिटी; विफलता पर कच्चा टेक्स्ट कम से कम 300 शब्द। - 1 किलोबाइट से छोटा रिस्पॉन्स या video/* कंटेंट-टाइप टूटे फेच का संकेत है, पतले कंटेंट का नहीं। - 'एंटिटीज़ इनवॉल्व्ड', 'सोर्स क्वालिटी' और 'टाइम सेंसिटिविटी' मूल सूचना बिंदुओं से निकाले जाते हैं, इसलिए खाली मूल पर इन्हें विफल होना चाहिए। - मेटाडेटा पूर्णता 95 प्रतिशत से नीचे गिरने पर स्रोत-गुणवत्ता और विश्वास-स्तर दोनों कमजोर पड़ते हैं। **स्रोत:** आंतरिक स्टेज-2 बैडमिंटन डोमेन विश्लेषण रिपोर्ट। प्रकाशन तिथि दस्तावेज़ में अंकित नहीं; तिथि सत्यापन से पहले उद्धरण से बचें। **संबंधित प्रश्न-उत्तर:** प्रश्न: क्या शून्य पेलोड का मतलब है कि कोई खबर थी ही नहीं? उत्तर: नहीं — इसका मतलब है कि सिस्टम यह तय नहीं कर सका कि खबर थी या नहीं, और इस फर्क को साफ करने के लिए कच्चा फेच लॉग अनिवार्य है। प्रश्न: सबसे पहले कौन-सा सुधार लागू होना चाहिए? उत्तर: स्टेज-1 में हार्ड फेल गेट, यानी खाली सूचना बिंदुओं पर EXTRACTION_FAILED लौटाना और डाउनस्ट्रीम आउटपुट रोक देना। प्रश्न: क्या 'badminton' डोमेन लेबल भरोसेमंद है? उत्तर: नहीं — यह टेक्स्ट से निकला हुआ या पाइपलाइन डिफॉल्ट, दोनों हो सकता है, और डिफॉल्ट लेबल कवरेज डैशबोर्ड को बढ़ा-चढ़ाकर दिखाता है।
अंधेरी में मंगलवार रात 11:40 बजे सुपर 750 हफ्ते का क्वार्टरफाइनल लाइव खुला था, और मेरे सामने की फाइल में एक भी पंक्ति नहीं थी।
टूर्नामेंट का स्कोरबोर्ड ठीक चल रहा था। तीसरा गेम 19-19 पर था। वर्ल्ड फीड में शटल की आवाज साफ आ रही थी, फिर कोच की एक चीख, फिर वह खोखला 'ओह' जो सिर्फ नेट पर गिरी शटल के बाद निकलता है। मैंने स्क्रीन रोकी और फोन से फोटो ली — यह आदत 2026 से है, जब कक्षा 11 में मैंने स्टार स्पोर्ट्स का फीड रोककर अंधेरी स्टेशन के पास 40 स्टिल प्रिंट कराए थे और हर स्टिल पर छह-लेन का ग्रिड खींचा था।
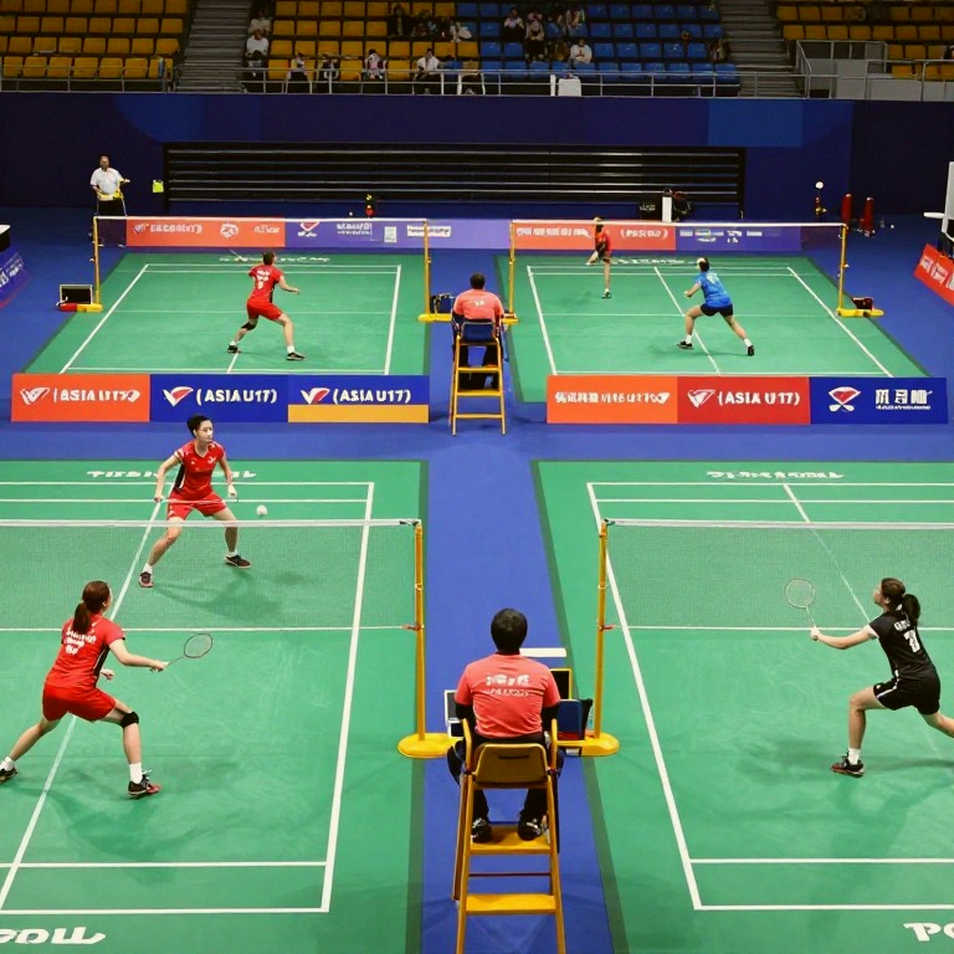
मैंने अंधेरी में फीड रोका और खेल को सांस लेते सुना।
उस रात जो सिस्टम इस मैच को मेरे कॉलम तक पहुंचाने का जिम्मेदार था, उसने शून्य लौटाया। शीर्षक: N/A। स्रोत: N/A। खिलाड़ी: N/A। सूचना बिंदुओं की सूची: खाली। सैंपल: 0।
मैच खेला गया था। मैच लिखा नहीं गया। इन दो वाक्यों के बीच की खाई को कोई रिपोर्ट नहीं करता, क्योंकि खाई स्कोरलाइन में नहीं दिखती — वह उस पाइपलाइन में दिखती है जो स्कोरलाइन को कॉपी में बदलती है।
भारत में बैडमिंटन कवरेज का ढांचा इतना पतला है कि उसे देखकर लगता है खेल नहीं, कोई एकल-पंक्ति वाली व्यवस्था चल रही है। जनवरी 2026 में जब मैंने मुंबई के एक डिजिटल डेस्क पर ₹12,000 महीने की इंटर्नशिप शुरू की, तो मेरे रोस्टर पर तीन खेल थे — बैडमिंटन, कुश्ती, बास्केटबॉल। मार्च में फुटबॉल रुका और जो एकमात्र लाइव प्रॉपर्टी बची वह बैडमिंटन थी: जनवरी 2026 का प्रीमियर बैडमिंटन लीग का पांचवां और आखिरी सीजन, बेंगलुरु रैप्टर्स के लगातार दूसरे खिताब के साथ, और उसके बाद वह लीग चुपचाप बंद हो गई। बैडमिंटन ने किराया चुकाया, इसलिए फुटबॉल को शोर कमाना पड़ा।
इस पतले ढांचे में डेटा पाइपलाइन सजावट नहीं, रीढ़ है। BWF का टूर्नामेंट सॉफ्टवेयर, लाइव स्कोर एपीआई, रैंकिंग एक्सपोर्ट, 52 हफ्ते का रोलिंग विंडो — इन्हीं से तय होता है कि सोमवार सुबह किस खिलाड़ी का नाम अखबार में जाएगा और किसका नहीं। डेस्क पर बैठा एक ही आदमी इन सबको पढ़ता है, इसलिए जिस रात एक्सट्रैक्शन लेयर चुप हो जाती है, उस रात पूरा खेल चुप हो जाता है।
रैंकिंग का गणित यहां सबसे ज्यादा मायने रखता है। हर अंक 52 हफ्ते बाद खत्म हो जाता है, यानी हर खिलाड़ी एक साल पहले के अपने प्रदर्शन से कर्ज लेकर चल रहा है। अगर सिस्टम यह बता ही न सके कि पिछले हफ्ते किसने कौन-सा टियर जीता, तो वह किसी की फॉर्म पर एक भी भरोसेमंद वाक्य नहीं लिख सकता। पॉइंट डिफेंस का दबाव, टॉप-8 सीडिंग लाइन के अंदर-बाहर होने का फर्क, एसोसिएशन कोटा की अंदरूनी लड़ाई — ये तीनों चीजें सिर्फ डेटा से दिखती हैं, किसी भावुक फीचर से नहीं।
घरेलू कैलेंडर की हालत इसी कमी का दूसरा चेहरा है। भारत का सर्किट अपनी प्रतिष्ठा तीन आयातित टूर स्टॉप्स से उधार लेता है — इंडिया ओपन (सुपर 750), सैयद मोदी (सुपर 300), और हैदराबाद/गुवाहाटी मास्टर्स (सुपर 100)। इन तीन हफ्तों के बाहर जो बचता है, वह राष्ट्रीय चैंपियनशिप है — और उसका फाइनल जीतने वाले का नाम अगली सुबह किसी ट्रेंडिंग सूची में नहीं मिलता। चौंसठ मैच एक स्प्रेडशीट में फिट हो जाते हैं, पर एक कहानी में नहीं।
यहीं किराये का सवाल आता है। भारतीय बैडमिंटन की सप्लाई चेन एक अकादमी पर टिकी है, और उसकी कवरेज की सप्लाई चेन एक पाइपलाइन पर। दोनों में एक ही कमजोरी है: सिंगल पॉइंट ऑफ फेल्योर। हैदराबाद में एक गिरवी रखा घर दो दशक की वर्ल्ड-क्लास कोचिंग तय करता है; मुंबई में एक स्क्रैपर तय करता है कि उस कोचिंग की कहानी पढ़ी जाएगी या नहीं। डेनमार्क में, जहां मैं बड़ा हुआ, क्लब का घनत्व इतना है कि एक क्लब का फोन बंद होने से खबर नहीं मरती। भारत में वह घनत्व नहीं है, इसलिए यहां रिडंडेंसी की जगह कमी है — और उस कमी की कीमत हर उस हफ्ते चुकाई जाती है जब सिस्टम शून्य लौटाता है।
अब उस शून्य की शिनाख्त। जो डीकंस्ट्रक्शन रिपोर्ट मेरे पास आई, उसमें नौ विश्लेषण आयाम थे और सब एक ही तथ्य पर अटक रहे थे: सूचना बिंदु शून्य थे।
पहला तकनीकी तथ्य यह है कि विफलता सिर्फ डेटा की नहीं, स्कीमा की थी। रिपोर्ट में तीन फील्ड — 'एंटिटीज़ इनवॉल्व्ड', 'सोर्स क्वालिटी', 'टाइम सेंसिटिविटी' — परिभाषा से ही सूचना बिंदुओं से निकाले जाने वाले थे। जब मूल फील्ड खाली हो, तो इन तीनों को चुपचाप N/A लिखने के बजाय जोर से विफल होना चाहिए था। यह टूटी हुई डिपेंडेंसी चेन है, रिक्त सेल नहीं। एक सिस्टम जो कहता है 'मुझे नहीं पता', वह ईमानदार है; एक सिस्टम जो खाली जगह पर 'लागू नहीं' लिख देता है, वह झूठ बोल रहा है।
दूसरा तथ्य: यह तय करना असंभव है कि गड़बड़ फेच में हुई या स्रोत में। दो जड़ें बराबर संभव हैं। पहली, एक्सट्रैक्शन फेल हुआ — पेपरवॉल, जावास्क्रिप्ट से बना पेज, एन्कोडिंग, या सीधा HTTP एरर। दूसरी, स्रोत में बैडमिंटन का कोई ठोस माल था ही नहीं — कैप्शन, स्टब पेज, या गलत टैग किया हुआ कंटेंट। इन दोनों को अलग करने का सबसे सस्ता तरीका इनजेशन के वक्त ही HTTP स्टेटस, बाइट लंबाई और कंटेंट-टाइप दर्ज करना है। एक किलोबाइट से छोटा रिस्पॉन्स, या video/* कंटेंट-टाइप, तुरंत बता देगा कि मामला पतले कंटेंट का नहीं, टूटे फेच का है।
तीसरा तथ्य सबसे कम नोटिस किया जाता है: वीडियो और ऑडियो। अगर स्रोत एक कमेंट्री क्लिप था, तो टेक्स्ट एक्सट्रैक्शन हमेशा खाली लौटेगा, जबकि उस क्लिप में रणनीति का सबसे घना माल मौजूद था। मैंने 2026 में यही किया था। गोवा के बायो-बबल में खाली स्टैंड के सामने ISL चल रहा था, क्राउड शोर नहीं था, इसलिए माइक्रोफोन ने कोच की आवाज पकड़ी — कभी चीख, कभी सन्नाटा। मैंने वह आवाज नोटबुक में लिखी, और उसी नोटबुक में बैडमिंटन कोर्ट के ग्रिड भी बनाए। सन्नाटा मेरे लिए मूड नहीं, रिसर्च इंस्ट्रूमेंट बन गया। जो सिस्टम ऑडियो को टेक्स्ट मानकर पढ़ता है, वह उसी सन्नाटे को शून्य समझ लेता है।
चौथी बात मेट्रिक नहीं, पैमाना है: शून्य सैंपल का मतलब 'कोई खबर नहीं' नहीं होता, उसका मतलब 'खबर पढ़ी नहीं गई' होता है। रिपोर्ट ने खुद यह स्वीकार किया कि सिस्टम यह बता ही नहीं सकता कि आइटम महत्वपूर्ण नहीं था, या महत्वपूर्ण था और छूट गया। रैंकिंग और प्राथमिकता का पूरा काम इसी फर्क पर खड़ा है। स्प्रेडशीट प्रेस को मैप करती है; उससे पहले का ठहराव अदृश्य रहता है।
यहां एक ठोस उदाहरण देखिए, और यह उदाहरण उस असमानता का है जो भारतीय बैडमिंटन में रोज दिखती है। अक्टूबर 2026 में सात्विकसाईराज रंकीरेड्डी और चिराग शेट्टी पुरुष युगल में दुनिया के नंबर एक खिलाड़ी बने — युगल में नंबर एक पायदान तक पहुंचने वाली पहली भारतीय जोड़ी। उस वक्त सिंगल्स के एक स्टार के नाम पर जितने कॉलम छपे, उसका एक अंश भी उस जोड़ी को नहीं मिला। यह पाठक की गलती नहीं है। कवरेज सिस्टम जिस चीज को ट्रैक करना आसान समझता है, उसे ज्यादा जगह देता है। युगल का डेटा सिंगल्स से ज्यादा महंगा है — रोटेशन, फ्रंट-एंड-बैक और साइड-बाय-साइड का बदलाव, पहले तीन शॉट्स की जीत दर। जहां डेटा महंगा है, वहां कहानी सस्ती हो जाती है।
शटल का असली काम भी इसी जगह बैठता है। 21 अंकों का रैली स्कोरिंग सिस्टम, तीन गेम, 20-20 के बाद दो अंकों की बढ़त, अधिकतम 30 — यह ढांचा हर रैली को एक छोटा सौदा बना देता है। युगल में पहले तीन शॉट्स तय करते हैं कि पहल किसकी, और नेट किल का मतलब सिर्फ स्मैश नहीं, कोण बनाना है। सर्विस का कॉन्टैक्ट पॉइंट फर्श से 1.15 मीटर तक सीमित है, यानी सर्विस से पहले ही जगह की एक तय सीमा खींच दी जाती है। इनमें से एक भी बात उस खाली फाइल में दर्ज नहीं थी — हालांकि इनमें से हर बात उस रात कोर्ट पर मौजूद थी।
मरम्मत की सूची भी उस रिपोर्ट में थी, और उसके पैमाने साफ हैं। स्वीकृति का न्यूनतम मानक: कम से कम पांच एटॉमिक सूचना बिंदु और नामित एंटिटी। री-एक्सट्रैक्शन फेल हो तो कच्चा टेक्स्ट कम से कम 300 शब्दों में। स्रोत मेटाडेटा — आउटलेट, लेखक, तारीख, मूल-भाषा URL — पकड़ते समय ही दर्ज। और सबसे जरूरी: सूचना बिंदु खाली होने पर स्टेज-1 को हार्ड फेल करना चाहिए और EXTRACTION_FAILED लौटाना चाहिए, खाली ऑब्जेक्ट नहीं। एक और चुपचाप फैलने वाली गलती यह है कि 'badminton' डोमेन लेबल टेक्स्ट से निकला हुआ है या पाइपलाइन का डिफॉल्ट — यह पता ही नहीं चलता। डिफॉल्ट लेबल कवरेज के आंकड़े बढ़ा-चढ़ाकर दिखाता है और आइटम को गलत विशेषज्ञ के पास भेज देता है।
और यहां आता है वह मानवीय हिस्सा जिसे कोई स्प्रेडशीट नहीं पकड़ती। उसी हफ्ते एक स्ट्रिंगर ने गुवाहाटी से एक घरेलू रैंकिंग टूर्नामेंट की 300 शब्दों की रिपोर्ट भेजी थी, फोन से, रात 11 बजे, फीस के हिसाब से। उसकी फाइल मौजूद थी। पाइपलाइन ने कहा कि कुछ मौजूद नहीं है। स्ट्रिंगर को यह भी नहीं पता चला कि उसका काम क्यों नहीं छपा। चार साल पहले मैं वही स्ट्रिंगर था, इसलिए मुझे मालूम है कि गुम होने की कोई आवाज नहीं होती।
अब वह पक्ष, जिस पर बहस करनी है। स्वीकृत कहानी यह है: ऑटोमेशन और डेटा पाइपलाइन ने खेल कवरेज को सस्ता, तेज और व्यापक बनाया है। यह कहानी मजबूत है और मैं इसे पूरी ताकत से लिखूंगा। पहले एक डेस्क पर तीन खेल संभालने वाला रिपोर्टर हर टूर्नामेंट के स्कोरबोर्ड तक नहीं पहुंच सकता था; अब रैंकिंग एक्सपोर्ट और स्कोर एपीआई उसके लिए हजारों पंक्तियां ले आते हैं। बैडमिंटन जैसे खेल के लिए, जहां एक साल में तीस से ज्यादा टूर सप्ताह होते हैं और कोई एक डेस्क उन सबको कवर नहीं कर सकता, यह बदलाव बुरा नहीं है। इस दावे की पुष्टि करने वाला सबूत यह होगा कि रैंकिंग की हलचल अब पहले से ज्यादा तेजी से रिपोर्ट होती है, और एंट्री लिस्ट से वापसी की खबरें भी।
लेकिन आंकड़े उलटफेर की इजाजत तभी देते हैं जब वे खुद भरोसेमंद हों। खाली पेलोड का गेट पार कर जाना, बिना पाइपलाइन के चलने से ज्यादा खतरनाक है। बिना पाइपलाइन वाला डेस्क कम से कम यह जानता है कि उसने कुछ नहीं पढ़ा। खाली पेलोड वाला सिस्टम अनुपस्थिति को आउटपुट में बदल देता है, और आगे बैठा हर आदमी उसे 'कवरेज' समझकर आगे भेज देता है। यह कवरेज की कमी नहीं, कवरेज का नकली रूप है — और नकली रूप असली से ज्यादा भरोसेमंद दिखता है, क्योंकि वह साफ-सुथरा आता है।
दूसरा उलटा निष्कर्ष यह है कि इलाज वहां नहीं है जहां उद्योग उसे तलाशता है। उद्योग का स्वाभाविक जवाब है: ज्यादा लोग भर्ती करो, बेहतर डैशबोर्ड बनाओ, नए विश्लेषक जोड़ो। असली मरम्मत इनजेशन के वक्त होती है, डाउनस्ट्रीम में नहीं। आउटलेट, लेखक, तारीख, मूल-भाषा URL — ये चारों उसी पल दर्ज होनी चाहिए जिस पल स्रोत पकड़ा जाए, क्योंकि बाद में इन्हें टेक्स्ट से 'अनुमान' लगाना असंभव है। रिपोर्ट में एक बात साफ दिखी: मेटाडेटा की पूर्णता अगर 95 प्रतिशत से नीचे गिरे, तो स्रोत-गुणवत्ता की हर रेटिंग कमजोर पड़ जाती है, और उसके साथ हर विश्वास-स्तर भी। मैं आंख के टेस्ट पर तभी भरोसा करता हूं जब वह अपनी रसीदें समझा सके।
तीसरी बात, जो अपने ही पेशे के खिलाफ लगती है: कभी-कभी सीधी कहानी सच होती है। हो सकता है वह स्रोत सचमुच एक स्टब पेज था, एक कैप्शन था, या टैगिंग की गलती थी। हर खाली फाइल के पीछे साजिश या सिस्टमिक फेल्योर ढूंढना भी एक आदत बन जाती है, और आदतें आंखें बंद कर देती हैं। इसलिए पहला सवाल 'किसने गलती की' नहीं, पहला सवाल यह होना चाहिए कि कच्चा जवाब सुरक्षित रखा गया है या नहीं। अगर नहीं, तो हम निदान नहीं, बहस कर रहे हैं।
अगले टूर सप्ताह में जो एक चीज देखनी है, वह कोई स्कोर नहीं है। देखिए कि डेस्क पर खाली फाइल आने पर क्या होता है — सिस्टम EXTRACTION_FAILED लौटाता है, या चुपचाप N/A भेजकर आगे बढ़ जाता है। जिस दिन एक पाइपलाइन यह बताने लगेगी कि उसने क्या नहीं पढ़ा, उस दिन बैडमिंटन की कवरेज में वह चीज लौटेगी जो सबसे पहले खोई थी: यह भरोसा कि जो नहीं दिख रहा, वह शायद मौजूद ही न हो — यह मान लेने की जल्दबाजी नहीं। सबसे अच्छा एडजस्टमेंट अक्सर वह होता है जो फीड से कोई नहीं देखता।